2024-02-12 神经网络是信息的一类表征方式,大模型是目前最优秀的表征方式
目前大模型是最有效的人工智能实现途径,但是未必是最高效的实现方式,必然还存在其他的信息表征和推理方式。 感知机模型是1958年提出的神经单元连接的架构,在此之后提出的反向传播算法确定下来训练和推理的架构,再之后残差网络、transformer等方案对神经网络架构和能效进行探索和尝试,成功通过庞大的矩阵模型拟合了人类智能。 迁移是有效的实验方法,分析已有方案的特点和达到优势效果本质原因,通过把优势效果本质原因迁移到新的方案上,既保留已有方案的优点,又摈弃已有方案的缺陷。
现有大模型架构的缺陷:
- 反向传播把训练和推理分开,实际上推理的过程也可以是模型训练进步的过程。
- 大矩阵的高维度拟合,使得权重黑盒。
- 大矩阵在训练时确定了参数规模,之后不会在训练过程中动态调整矩阵形状。
- 矩阵运算、反向传播消耗大量的GPU计算开销。
我认为需要克服1-3缺陷才能真正达到拟人化的智能,即在使用中持续学习、学习过程公开透明、学习过程对模型架构具备自主动态调节能力。对于第3点,meta发现神经网络也可以利用额外的空间存储信息,Vision transformers need registers,2024,在此研究的基础上,神经网络能否自己决定怎么申请额外的空间吗?4是基础算法缺陷导致的资源限制,在未来普通笔记本或者边缘设备也足够支撑完整智能模型的计算开销,但是反向传播无论再怎么极限的优化架构,面对海量的参数,能否真的做到这样低需求性能吗?
2025-05-18 固定搭配与高维关系
“小孩子的脸蛋红红的像苹果”
对于这句话的编写是联想和记忆的能力共同作用。脑海中先有概念的联想,孩子脸-红苹果,然后完善出完整的句子,完善句子的过程是基于记忆。
“孩子脸”是一个概念,不是常用的日常表达。“小孩子的脸蛋”是常用的记忆组合。这二者一个是概念,一个是表达语言,都是固定的(词汇)搭配形式。“小孩子的脸蛋红红的像苹果”是逻辑联想,在两个概念间的联想关系是另一个概念。
A-B的联想足够强烈,可以组成AB的固定搭配。但是A-D-E的联想关系也足够强烈,却不是组成ADE的固定搭配,而是AE之间有D的关系,D是描述AE联想权重的高维形式。这里的A-B可以理解为“孩-子”,“A-D-E”可以理解为“孩子脸-像-苹果”。这里还存在一个问题:同样都是连接,该可以区分A后面跟着B,还是A和B具有某种高维联系?
语言能力
语言能力的过程是联想出来的。强烈的记忆连接使得这个联想过程非常迅速,变成了本能,因而无法察觉。
个人的差异使得每个人的用语用词有一些区别,或者在表达能力上也有强弱,显得有些人嘴拙、有些人嘴巧。未来每个人可以定制化大模型,减弱通用模型的AI味,更加符合人类的差异性。
2025-05-19 排列组合构建语言连接的复杂度会爆炸
这里构造连接的形式又有2种思路。前者更加精简,后者能表达更多的上下文信息。
(1)按照顺序选择,必须一一连接,小-孩,小-子,小-的,..,小孩-子,…,小孩-的,小孩-脸,…小孩子的脸-蛋,…,小-孩子的脸蛋 这个问题可以形式化为有序字符序列上的带分隔符子序列计数,从n个字符中选择k个字符,只能选1个空隙放-,结果为公式(1),运算量是阶乘。
\[S1(n)=\sum_{k=2}^{n}\binom{n}{k}\left(k-1\right) (1)\](2)按照顺序选择,必须一一连接,小-孩,小-孩-子,小-子-孩,小-的,..,小孩-子,…,小孩-的,小孩-脸,…小孩子的脸-蛋,…,小-孩子的脸蛋 这个问题可以形式化为有序字符序列上的带分隔符子序列计数,从n个字符中选择k个字符,至少选1个空隙放-,结果为公式(2),运算量是阶乘*指数。
\[S2(n)=\sum_{k=2}^{n}\binom{n}{k}\left(2^{k-1}-1\right) (2)\](3)可以不按顺序选择,选择必须一一连接,小-孩,小-子,小-的,小-脸,…,小子-孩,小脸-的,小孩脸- 的,小孩-子,小孩-的,小孩-脸,…小孩子的脸-蛋,…,小-孩子的脸蛋
\[S3(n)=\sum_{k=2}^{n}P\binom{n}{k}\left(2^{k-1}-1\right) (3)\](4)可以不按顺序选择,可以多个组合,小-孩,小-孩-子,小-孩-子-的,…,小孩-子,小孩子-的-脸,小孩-子-的脸…小-孩-子-的-脸
\[S4(n)=\sum_{k=2}^{n}P\binom{n}{k}\left(2^{k-1}-1\right) (4)\]直接构造连接阶乘级别的运算量显然是无法进行的,因此需要大量剪枝。长记忆和短记忆也不应该使用相同的机制,长记忆应该更加擅长遗忘,或者说,长记忆应该进行压缩。
即便不考虑交换顺序,公式(1)运算量评估也很大
| n | S1(n) | n | S1(n) |
|---|---|---|---|
| 1 | 0 | 16 | 458,753 |
| 2 | 1 | 17 | 983,041 |
| 3 | 5 | 18 | 2,097,153 |
| 4 | 17 | 19 | 4,456,449 |
| 5 | 49 | 20 | 9,437,185 |
| 6 | 129 | 21 | 19,922,945 |
| 7 | 321 | 22 | 41,943,041 |
| 8 | 769 | 23 | 88,080,385 |
| 9 | 1,793 | 24 | 184,549,377 |
| 10 | 4,097 | 25 | 385,875,969 |
| 11 | 9,217 | 26 | 805,306,369 |
| 12 | 20,481 | 27 | 1,677,721,601 |
| 13 | 45,057 | 28 | 3,489,660,929 |
| 14 | 98,305 | 29 | 7,247,757,313 |
| 15 | 212,993 | 30 | 15,032,385,537 |
短记忆窗口为多少,长记忆压缩的阈值是多少,长记忆如何压缩的准确。
2025-05-20 排列组合的统计如何理解到代指的含义
如果信息只是简单的在两个概念间建立连接,语言能力中的代指称呼“他”则需要一定的逻辑推断。 “老板告诉员工他明天要加班”和“孩子告诉妈妈他想睡觉”,视频出自(注意力机制到底在做什么-过拟合青年)[https://www.bilibili.com/video/BV1fX536iExn]
2025-05-25 互信息组词能否延展
互信息是分词的常见手段,能否构建信息的连接关系?
2025-05-26 连接建立优化
输入文本字符串,对文本字符串做选择组合建立连接会非常难,
1 相邻字符建立连接 2 每一个字符按照频率记录一个权重,权重高的和当前字符建立连接 3 随着输入增多,每个字符的权重会缓慢降低
2026-07-06 计算与记忆都是连接
记忆是在两个实体间建立联系,计算是这个实体寻找在某个上下文中联系紧密的实体。上下文是信息在低维度的展开。
举例而言:
示例1:大脑乘法的过程。
对于简单的乘法运算,大脑会自动匹配到乘法表,联想起来熟悉的连接节点。输入89,联想到8972或者八九七十二。对于复杂的乘法运算,7860,大脑会先联想到高位乘法,联想到高位乘法计算步骤,然后代入进去运算。这个过程是基于大脑建立了高位乘法-高位乘法计算步骤-应用方式。
2026-09-19 关于大脑认知的2个视频
2026-09-19 如何描述无法理解的事物
看到语言学的一篇文章电被发明以前,电鳗叫什么呢?,在电发明之前,电鳗叫作什么?在眼镜发明之前,眼镜蛇叫作什么?
这是一个非常有趣的问题,触及了语言哲学、命名与指称、概念史。通过在部落或者早期文献的考据,可以得到答案。电鳗被称作剥夺行动能力之物、麻木鳗、颤抖鱼,而眼镜蛇是叫作饭铲头、扁颈蛇、过山风。这个命名过程是一种概念上的类比和指代,一个统称的名字往往会描述或类比一件物品的特征,同时这个名字也会让人联想到他的特征。比如眼镜蛇会使人联想到剧毒。
果然,人无法描述无法理解、没有见过的事物,现实中描述、命名、代指事物的本质仍然是通过类比联想。
2026-10-07 三文鱼的代指
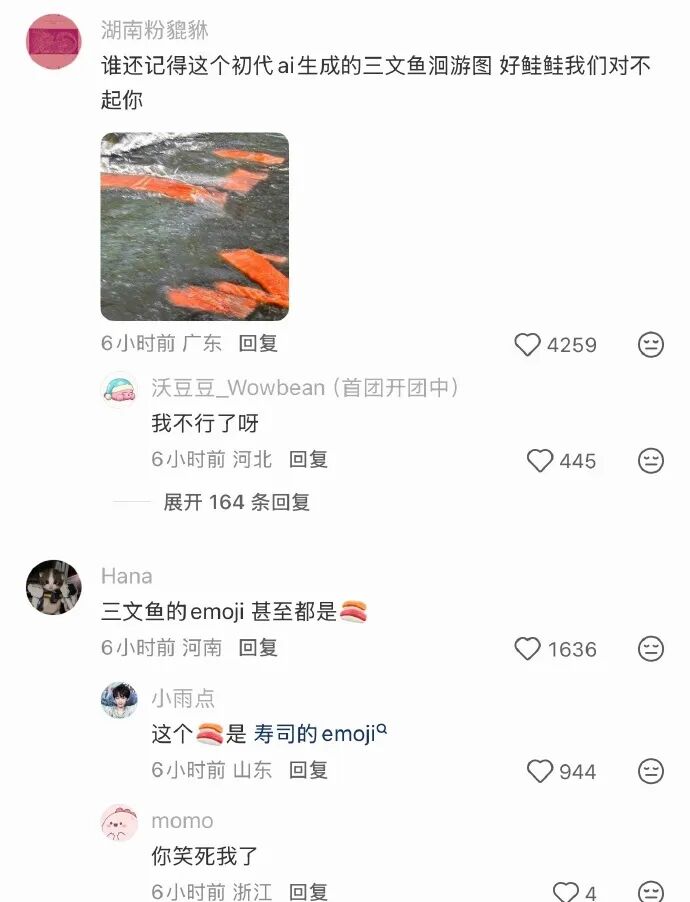
另一个有趣的见闻是ai生成的三文鱼洄游的图片。前几年,全球互联网上火过一张非常滑稽的图片。在早期人工智能绘画工具刚流行时,有网友输入提示词,想画一幅三文鱼洄游图。结果AI画出来的,是一群切得整整齐齐、带着白色脂肪纹理的橙红色生鱼片,在清澈的溪流和瀑布中逆流跳跃。对于这个初代AI生成的名场面,网友调侃道:“好鲑鲑,我们对不起你。”AI闹出这个笑话的原因很简单,它本身没有生物常识,完全依靠人类投喂的语言数据来学习。在全人类的互联网语料库里,这个词语关联的照片绝大多数都是日料店的摆盘、刺身和超市冷柜里的鱼排。
2026-09-19 连接主义
我是纯粹的连接主义,大脑计算的本质是对特征的连接,所有计算、判断、记忆的本质都是连接。
大模型训练高维特征、计算上下文得到结果,训练QKV是拟合的连接结果,上下文是一种连接计算的形式。一方面大模型的巧思令我敬佩不已,另一方面,我对大模型中的方式一直嗤之以鼻,他的本质是用高维拟合连接的网络,拟合贝叶斯网络,而非直接构建一套连接或者贝叶斯概率网络。
2026-09-19 推理具备反馈作用
- 推理应该学会判断能否推理,提前终止错误的推理
- 推理结果的正确性应该反馈于推理参数
2026-09-20 记忆可以多层折叠
从LSTM到transformer,大家神经网络在设计中,巧妙地认识到记忆应作用于不同距离,并实现了实践应用。但是,记忆随着距离的增加不应该是衰减,而是折叠。大脑在计算后文时,对远距离的长文不是完全的遗忘,应该是获取其中最关键的标记信息/索引信息,如果远距离的长文对当前任务进展没有影响,那么仅计算简短的标记信息,如果可能对当前任务可能有帮助,这段记忆可以再次进行回忆和复盘。在极端状态下,如果记忆非常长(比如一个任务执行了10年),那么可能进行多层折叠,形象类比为文档的大纲结构。
2026-09-21 信息的增多使得信息无效且被忽略
动脑子是一个费力的事情,大模型每次输出和生成的内容过于庞大。辨析消化并接受会消耗大量的精力,最终导致人类放弃校验,反而降低了信息的可信有效。同时大量无效或者低效信息中,可能隐藏混杂的关键信息,但是人类一旦放弃仔细分辨,也会遗漏其中的关键内容。 在现实世界,很多国企领导要求需要大篇幅的文档,比如维护100页以上的设计文档、开发文档、测试文档,由于只要求页数的工作量,导致花费大量人力编写文档,丝毫不考虑开发过程中进度需求变更后旧文档时效性、文档内容与工程实践的贴合度,导致最终产出的文档是浮于流程和形式。
2026-09-29 学习不是反复记忆,而是反复使用
反复记忆的东西很容易遗忘,而且很难掌握牢固,但是需要使用的知识往往可以很快掌握。 语言是这样的,英语学习了20年,不如在英语使用环境生活1年。曾经倒背如流的诗词文章几个月不用就会忘掉,但是如果偶尔诵读,就可以牢记于心。
2026-10-07 睡眠对于记忆是很重要的主动加工过程
睡眠在离线状态下重放和重组记忆痕迹,将新学的、脆弱的记忆转化为稳固的长期记忆,并整合到已有的知识网络中。这包括对信息的再加工、信号强化放大、噪音筛选过滤。因此在学习的过程中,需要回顾整理已学会 知识。
2026-10-07 大脑构建基础能力和构建记忆知识库两码事
前者需要频繁的短睡眠,后者需要间隔更长的睡眠。前者需要更大的好奇心,后者需要更好的映射类比到已有的知识中。
婴儿的成长特点不是铁证,可以作为这个结论的参考佐证。
上述断言过于二元对立和绝对,应谨慎看待。
2026-10-07 好奇心可以提升学习能力
大模型的拟合过程是机械的强制加工,缺乏好奇心使得他无法主动学习,无法自我调整。
2026-10-11 DeepSeek的招聘既提高了门槛,也降低了门槛
我觉得我大概知道他们需要什么样的人。避免墨守陈规,拒绝过分的老实人,拒绝经验性的稳重,因为这些都是可以培养的,市场上大把存在这样编程了10-20年的传统程序员和大厂程序员。DeepSeek需要天才般的创造力,需要一些灵性光辉,需要打破已有的架构,需要观察力和洞察力,他们不招聘有经验的大厂,反而看重跨域的极致人才。我眼里里的人才又不一样,人才最关键的是对问题本质的洞察力和面对挫折时的坚毅。当然投简历Deepseek的人太多了,所以他们需要一层过滤。
DeepSeek需要第三类的人才三类工作。
2026-10-13 模式匹配
回到这个问题,同样都是连接,该可以区分A后面跟着B,还是A和B具有某种高维联系?问题在于把高维压缩的权重模型展开为二维的连接,缺失了高维信息的表达能力。为了弥补这个缺陷,需要在二维上填充内容,即二维的上下文。
“孩-子-脸”可以补一个弱连接,“孩-后面-子-后面-脸” “孩子脸-像-苹果”可以补一个弱连接 孩子脸-像-苹果 | | | 比喻
最终的问题在于输入信息和已有信息的匹配上,这里也许依靠模式匹配可以解决?而且是需要具备一定模糊性的模式匹配。
2026-10-16 可解释性
神经网络可解释性被AI解决了?90%神经元只有一个功能 https://mp.weixin.qq.com/s/_oqtFLpXkFSufQGz-adGHQ
2026-10-17 学习不是反复记忆,统计意义的高频反而可能降低信息量
反复出现相同的东西不会提升记忆模型,差异化的组合应用和适当的重复才会存在信息量。